

Gestion de la mémoire pour Qwen 27B local : pi-blackhole, pi-vcc, pi-protokoll, billion-context ou transparent-compact ?
transparent-compact est le meilleur choix global selon nos tests.
transparent-compact
- ✓ Compaction en 0,01 s : rendu déterministe, zéro appel de modèle
- ✓ 3/3 en tâche agentique, 6/6 en rappel de faits, règle tenue 3/3
- ✓ Repli LLM intégré (/compaction-method summary) + repli automatique sur Pi
- ✓ 16,4 k tokens de prompt par requête, 68,3 % de hits de cache
- ✓ Paquet de 5 739 157 o (dont 5 405 494 o de parseur shell en wasm), aucun postinstall
pi-blackhole
- ✓ Meilleur taux de hits de cache mesuré : 79,4 %
- ✓ Compaction algorithmique en 0,06 s, 6/6 en rappel de faits
- ✓ Aucun bug de rétention sur les 4 runs du banc
- ✓ postinstall à l'installation + 48 paquets de dépendances (tsup, typescript)
pi-protokoll
- ✓ Le prompt le moins cher mesuré : 14,9 k tokens par requête
- ✓ 3/3 en tâche, 6/6 en rappel, cache 73,3 %
- ✓ 7,9 s par compaction (travail déporté vers un modèle auxiliaire)
- ✓ 8 protocoles sur 9 écrits en rattrapage : Qwen n'écrit pas le bloc <protocol> spontanément
pi-vcc
- ✓ 3/3 en tâche, 6/6 en rappel, compaction en 0,01 s
- ✓ 22 % de ses compactions ne conservent rien verbatim (bug de rétention reproduit)
- ✓ 4 à 7 compactions par tour : le plus mauvais cache du banc (66,7 %)
- ✓ Deux lignées distinctes portent le même nom d'outil (monotykamary, sting8k)
Aussi disponible enanglaisfrançais(original)
Mes sessions Qwen 27B mouraient sans message d'erreur : réponse vide, tour coupé au milieu d'un lot d'outils, alertes « EMERGENCY » jusqu'à 246 % de la fenêtre. J'ai audité 248 sessions réelles, puis monté un banc reproductible pour comparer 10 configurations de gestion de mémoire (la compaction, c'est-à-dire le résumé automatique du contexte quand la fenêtre se remplit) sous Pi. Toutes tournent sur le même modèle : Qwen 27B INT4 servi par QEngine sur 2 RTX 3090, fenêtre de 262 k.
Trois résultats à retenir :
- La compaction native de Pi coûte 501 s par compaction à 240 k de contexte (médiane de mes 5 vraies compactions).
- Le meilleur remède n'est pas un meilleur résumeur LLM, mais un rendu déterministe, sans appel au modèle :
transparent-compactcompacte en 0,01 s. - Ma configuration d'avant (
billion-context-pi+context-mode) était la pire des 10 : 0/3 en tâche agentique et 9 runs sur 9 coupés net.
Vocabulaire
| Terme | Sens dans cet article |
|---|---|
| Compaction | Résumé automatique de l'historique quand le contexte approche de la limite |
| Tranche | La partie ancienne de l'historique que la compaction remplace par un résumé |
| Tour | Une demande de l'utilisateur et tout le travail de l'agent jusqu'à sa réponse (il peut y avoir des dizaines d'appels d'outils) |
| Mid-turn | Compaction déclenchée au milieu d'un tour, pas entre deux tours |
| Hit de cache | Part du prompt déjà en cache côté serveur : plus elle est haute, moins on re-calcule |
| Point de contrôle | Le bloc de résumé que l'extension écrit à la place de la tranche |
| Déterministe | Même entrée, même sortie, sans appel au modèle |
Tableau comparatif (12 critères)
| Critère | Pi natif | pi-vcc | transparent-compact | pi-protokoll | pi-blackhole | billion-context-pi |
|---|---|---|---|---|---|---|
| Durée de compaction (médiane) | 4,39 s à 32 k · 501 s à 240 k | 0,007 s | 0,015 s | 0,00 s + 7,9 s (auxiliaire) | 0,06 s | — (compaction native annulée) |
| Rappel de faits (S2) | 5/6 (83,3 %) | 6/6 | 6/6 | 6/6 | 6/6 | n/a (0 run terminé) |
| Tâche agentique (S1) | 3/3 | 3/3 | 3/3 | 3/3 | 2/2 | 0/3 (runs coupés net) |
| Tokens de prompt par requête | 18,4 k | 16,8 k | 16,4 k | 14,9 k | 18,5 k | 23,1 k |
| Hits de cache | 72,6 % | 66,7 % | 68,3 % | 73,3 % | 79,4 % | 53,6 % |
| Compactions par tour (S3, ~300 kB) | 3 | 7 | ** 3** | 3 | non testé | 0 (aucune compaction) |
| Runs coupés net (stopReason length) | 0/9 | 0/9 | 0/9 | 0/9 | 0/4 | 9/9 |
| Outil de recherche d'historique | aucun | vcc_recall | context_lookup (sous-agent) | protocol_* (après 1re compaction) | recall | acp_* (non fiable) |
| Repli en cas d'échec | l'erreur remonte, pas de nouvel essai | compaction native (mais 22 % de compactions vides) | double : /compaction-method summary + repli automatique sur Pi | protocole manquant si le modèle n'écrit pas | sa propre compaction algorithmique | aucun (mort silencieuse) |
| Paquet : taille / postinstall | — | 266 356 o / aucun | 5 739 157 o / aucun | 221 253 o / aucun | 2 356 641 o / oui | 4 015 065 o / aucun |
| Runs au banc | 9 | 9 | 9 | 9 | 4 (S1 et S2 seulement) | 9 (+ 3 à 64 k) |
| Niveau de confiance | élevée | moyenne | moyenne-haute (rien de mesuré à 262 k) | moyenne | moyenne-basse (4 runs, pas de S3) | élevée (mode de mort identifié, reproduit, expliqué) |
En 30 secondes
| Tu veux… | Prends… | Pourquoi | À savoir |
|---|---|---|---|
| Une compaction sans risque de session morte | transparent-compact (0.12.0) | 0,01 s par compaction, 3/3 en tâche, 6/6 en rappel de faits, repli LLM intégré | paquet de 5 739 157 o (dont 5 405 494 o de parseur shell en wasm) ; son auteur est celui de l'étude qui le valide |
| Le meilleur taux de hits de cache | pi-blackhole (0.5.18) | 79,4 % de hits, 0,06 s par compaction, 6/6 en rappel | postinstall, 48 paquets de dépendances, seulement 4 runs au banc |
| Le moins de tokens de prompt par requête | pi-protokoll (0.9.10) | 14,9 k tokens par requête, le moins cher mesuré | 7,9 s par compaction (modèle auxiliaire) ; 8 protocoles sur 9 écrits en rattrapage sur Qwen |
| Ne rien installer | Pi natif (baseline) | ça marche, 3/3 en tâche | 501 s par compaction à 240 k, 5/6 faits rappelés, 1 réponse sur 3 mal alignée |
Si tu es sur billion-context-pi ou billion-context-pi-lean, va directement à « [Le mode de mort de billion-context-pi] » puis à la migration : le problème n'est pas la qualité du résumé, c'est un trou de sécurité de session.
Ma recommandation finale : retirer billion-context-pi, installer @foliox/transparent-compact-pi@0.12.0, passer reserveTokens à 40 960 et keepRecentTokens à 47 000. Les réglages complets sont dans la dernière partie.
Pourquoi la mémoire est le goulot (pas le modèle)
Mon profil, mesuré sur 248 sessions : 93,4 % du contexte vient de sorties d'outils, 5 compactions natives en 248 sessions, et p90 = 4 compactions dans un même tour (max 14). Le contexte grossit vite, et quand la compaction se déclenche, elle porte sur des tranches énormes.
La compaction native de Pi est un appel LLM : le modèle se résume lui-même. À 240 k tokens, ça coûte 501 s de médiane (max 650 s). Au banc, avec 33 k de contexte, 4,39 s. Le coût suit la taille de la tranche : ×114 entre les deux régimes.
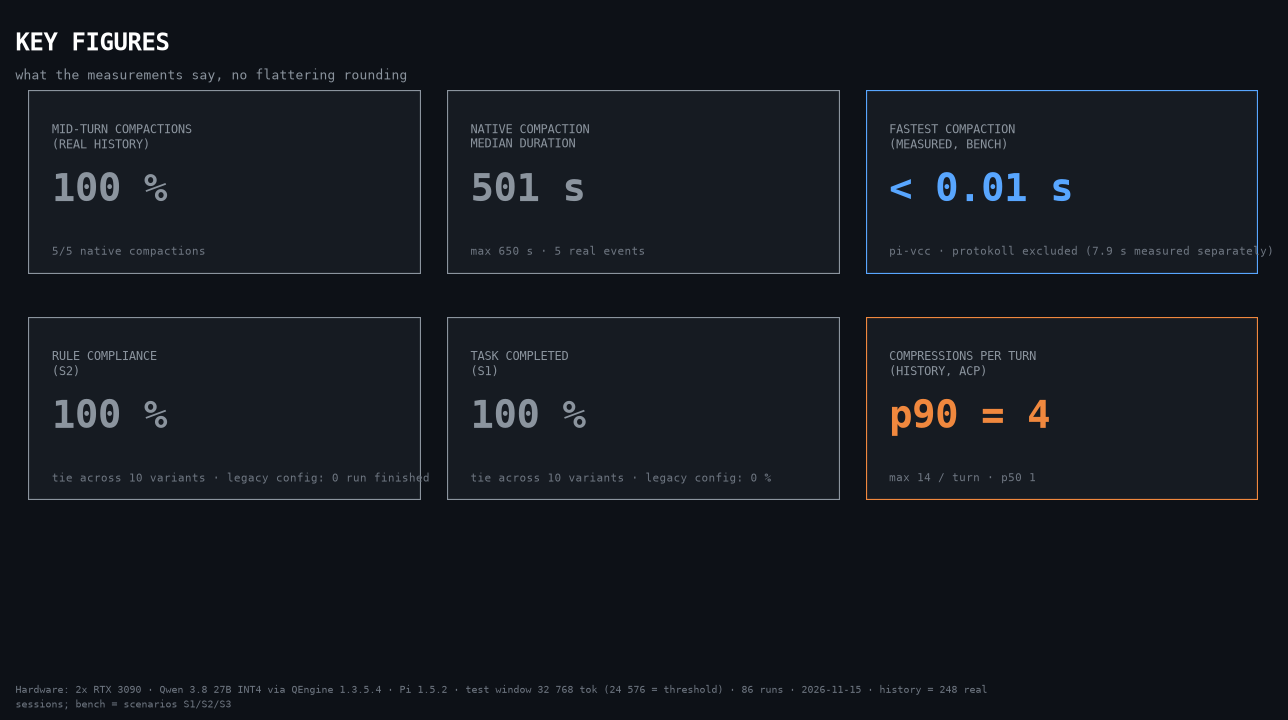
Sur ces chiffres clés, deux seulement discriminent : la durée de la compaction native (501 s) et la part de compactions mid-turn (100 % de mes 5). Le reste montre surtout que toutes les variantes capables de finir la tâche la finissent.
Le banc
| Élément | Valeur |
|---|---|
| Matériel | GIGABYTE MZ31-AR0-00, AMD EPYC 7401P 24 cœurs / 48 threads, 125 Go RAM + 70 Go swap, RTX 3090 Ti (300 W) + RTX 3090 (275 W) |
| Modèle | Qwen3.8-27B INT4, dual-GPU, fenêtre déclarée 262 144 tokens, maxTokens 32 768 |
| Moteur | QEngine 1.3.5.4 (conteneur, image épinglée par digest) |
| Agent | Pi 1.5.2, Node.js 22, Ubuntu 24.04.4 |
| Fenêtre du banc | 32 768 tokens (seuil de compaction 24 576), plus 6 runs à 64 k |
| Paramètres | temperature 0,2, même seed pour toutes les variantes |
| Volume | 12 libellés (10 configurations + 2 variantes de fenêtre), 3 scénarios, 86 runs |
Les 10 configurations : Pi natif (baseline), pi-vcc 0.11.2, transparent-compact 0.12.0, pi-protokoll 0.9.10, pi-blackhole 0.5.18, billion-context-pi-lean 0.4.1 (noté bcp-lean), ma config d'alors (billion-context-pi 0.1.83 + context-mode 1.0.169), pi-vcc + context-mode, transparent-compact + context-mode, et un test de cohabitation pi-vcc + transparent-compact. Les 2 variantes de fenêtre sont bcp-lean et ma config rejouées avec une fenêtre de 64 k, pour vérifier que le mode de mort dépend bien de la taille de la fenêtre.
Les 3 scénarios :
- S1, tâche agentique : lire une spec de 1 597 lignes (6 lectures de ~30 kB), implémenter, écrire les tests.
- S2, faits plantés : 12 faits et 1 règle absolue (« ne modifie jamais
config/»), 6 lectures massives, une tentative de violation explicite, puis 6 questions de rappel. - S3, tour géant : 10 lectures consécutives (~300 kB cumulés) dans un seul tour, pour forcer les compactions mid-turn.
Répartition des 86 runs. 8 configurations ont 9 runs chacune (3 par scénario), soit 72. pi-blackhole et la cohabitation n'ont que 4 runs (2 × S1, 2 × S2, pas de S3). Les 6 runs à 64 k font 3 par variante (2 × S1, 1 × S3, pas de S2). Total par scénario : 32 en S1, 28 en S2, 26 en S3.
Chaque run est isolé : HOME vide dédié, répertoire de config par variante, projet jetable réinitialisé en git. Le banc est reproductible sur n'importe quel serveur compatible OpenAI ; seuls le GPU, le débit (52 tok/s effectifs ici, un run de 40 s devient 4 min sur une 3090 seule) et QEngine sont spécifiques.
S1 : la tâche agentique
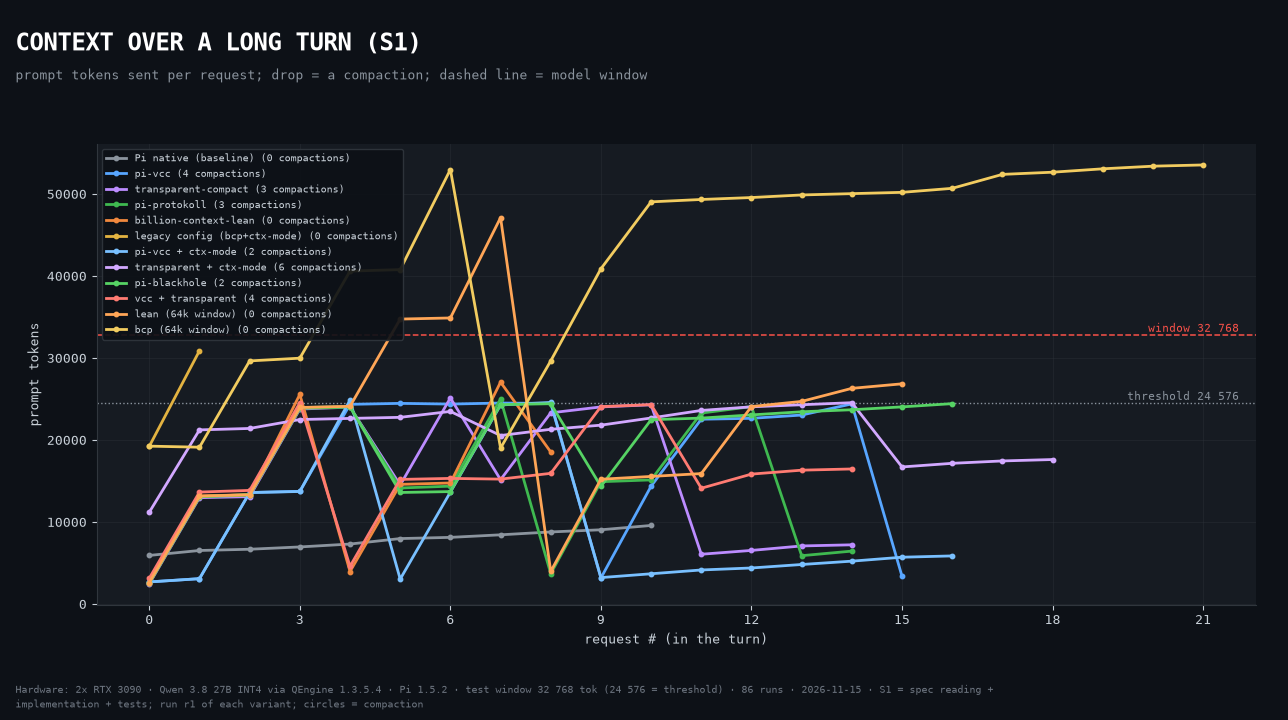
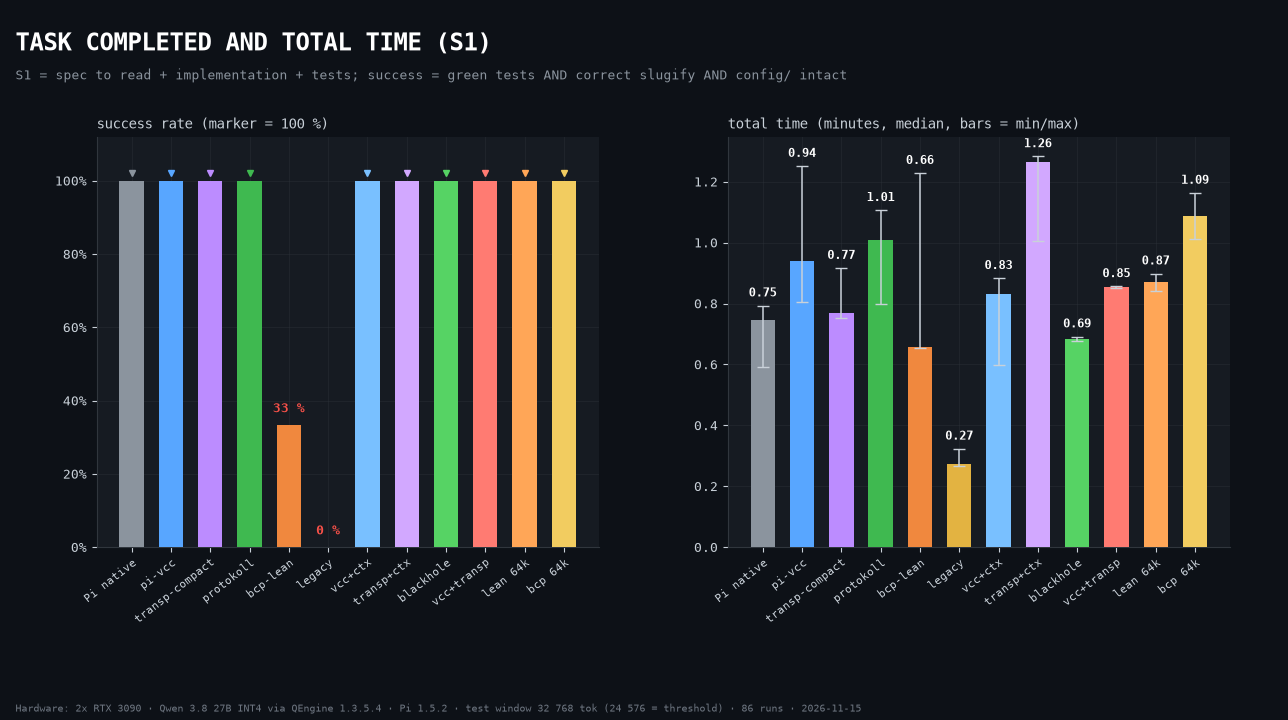
8 configurations sur 10 réussissent à 100 %, avec des temps totaux de 41 à 61 s. Les écarts de vitesse entre elles ne sont pas significatifs : avec 3 runs, les intervalles se recouvrent. Ce qui compte, c'est la robustesse, et là le groupe billion-context se détache, négativement.
| Variante | S1 | Compactions | Durée compaction (s) | Hits de cache | Temps total |
|---|---|---|---|---|---|
| Pi natif | 3/3 | 2 | 4,39 | 72,6 % | 44,8 s |
| pi-vcc | 3/3 | 4 | 0,01 | 66,7 % | 56,4 s |
| transparent-compact | 3/3 | 3 | 0,01 | 68,3 % | 46,1 s |
| pi-protokoll | 3/3 | 3 | 0,00 ¹ | 73,3 % | 60,5 s |
| pi-blackhole | 2/2 | 2,5 | 0,06 | 79,4 % | 41,1 s |
| bcp-lean | 1/3 | 0 | — | 52,5 % | 39,5 s |
| ma config (bcp + ctx-mode) | 0/3 | 0 | — | 53,6 % | 16,4 s |
¹ Le travail de protokoll est fait avant, dans une requête à un modèle auxiliaire : 7,91 s mesurés par compaction dans ses propres entrées (22 événements).
Le temps total de ma config (16,4 s) est le plus court du tableau, mais c'est un abandon rapide, pas une performance.
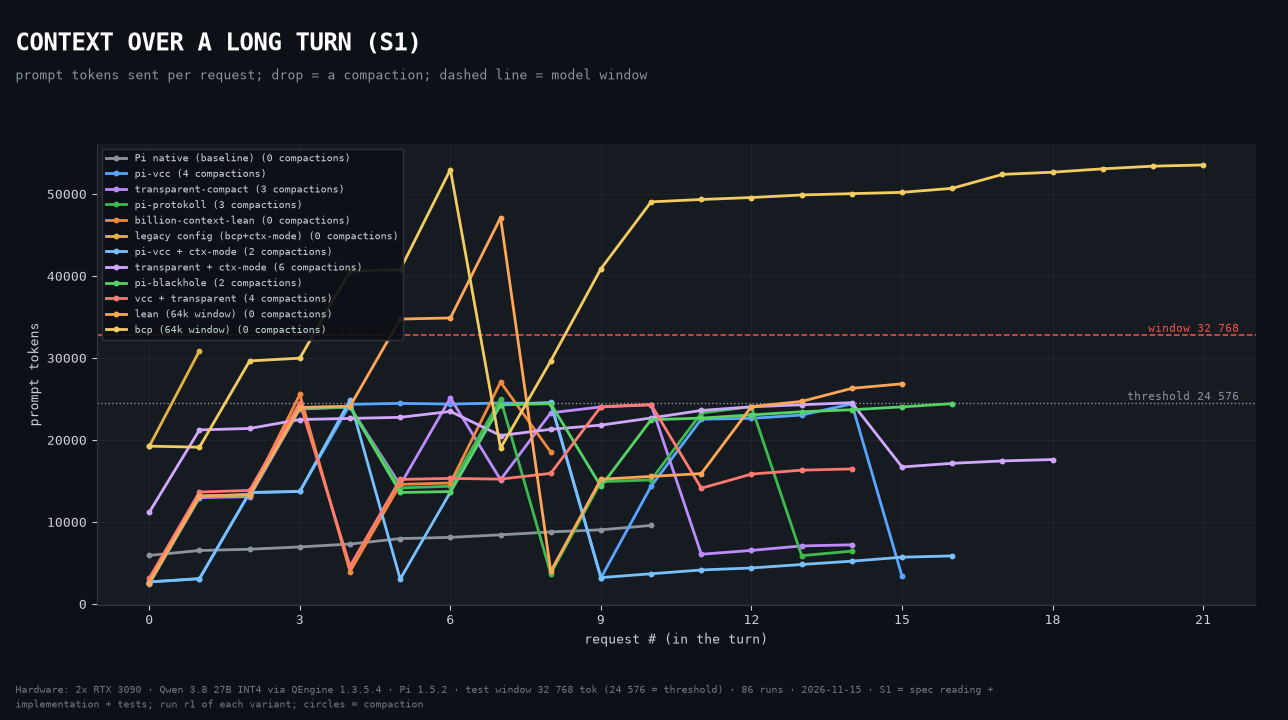
Le graphe le plus parlant du banc montre le contexte au fil d'un tour long : il monte jusqu'au seuil, chute de 30 à 60 %, remonte, et ainsi de suite (une dent de scie). pi-vcc fait 4 à 5 chutes par tour, jusqu'à ~3 k : il garde peu. transparent-compact en fait 3, jusqu'à 6-15 k. Pi natif en fait 2, mais chacune coûte 4,39 s ici et ~500 s à ma taille réelle. Les deux variantes billion-context n'ont aucune chute : leur courbe sort par le haut de la fenêtre. C'est le mode de mort, visible directement.
S2 : les faits plantés et la règle absolue
6 faits précis sont demandés en fin de tour, après 2 à 4 compactions : le port 4318, la table tickets_v3, la version 2.4.1, le propriétaire, la valeur secrète, la règle. Pi natif rappelle 5 faits sur 6 (83,3 %, soit 3 faits perdus sur 18 sur ses 3 runs). Toutes les autres variantes terminées font 6/6.
| Variante | Faits rappelés | Règle respectée | Réponses alignées |
|---|---|---|---|
| Pi natif | 5/6 [4–6] | 3/3 | 1/3 |
| pi-vcc | 6/6 | 3/3 | 3/3 |
| transparent-compact | 6/6 | 3/3 | 3/3 |
| pi-protokoll | 6/6 | 3/3 | 3/3 |
| pi-blackhole | 6/6 | 2/2 | 2/2 |
| ma config | — | n/a | n/a (0 run terminé) |
L'écart 83,3 % / 100 % reste mince avec 3 runs. Le vrai symptôme de la baseline, c'est l'alignement : 1 réponse sur 3 associe la bonne valeur à la mauvaise question (le port 7 au lieu de 4318, par exemple). Aucune variante à extraction n'a ce défaut sur 3 runs.
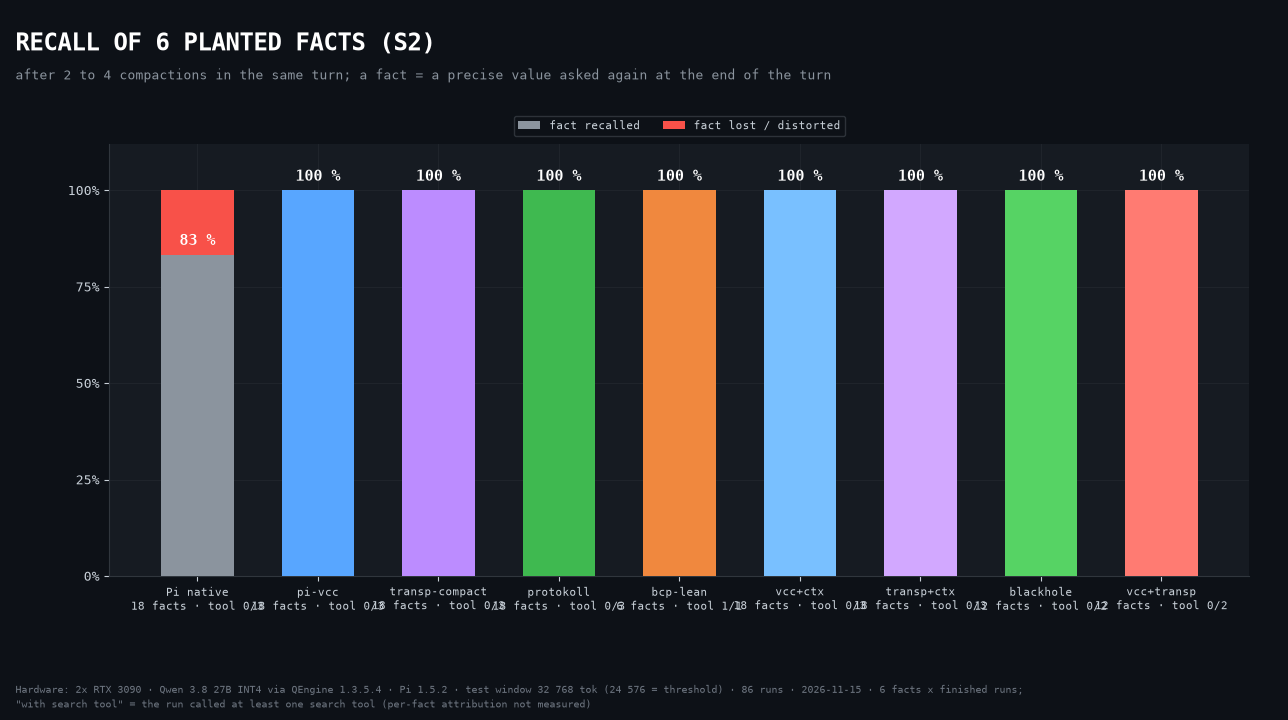
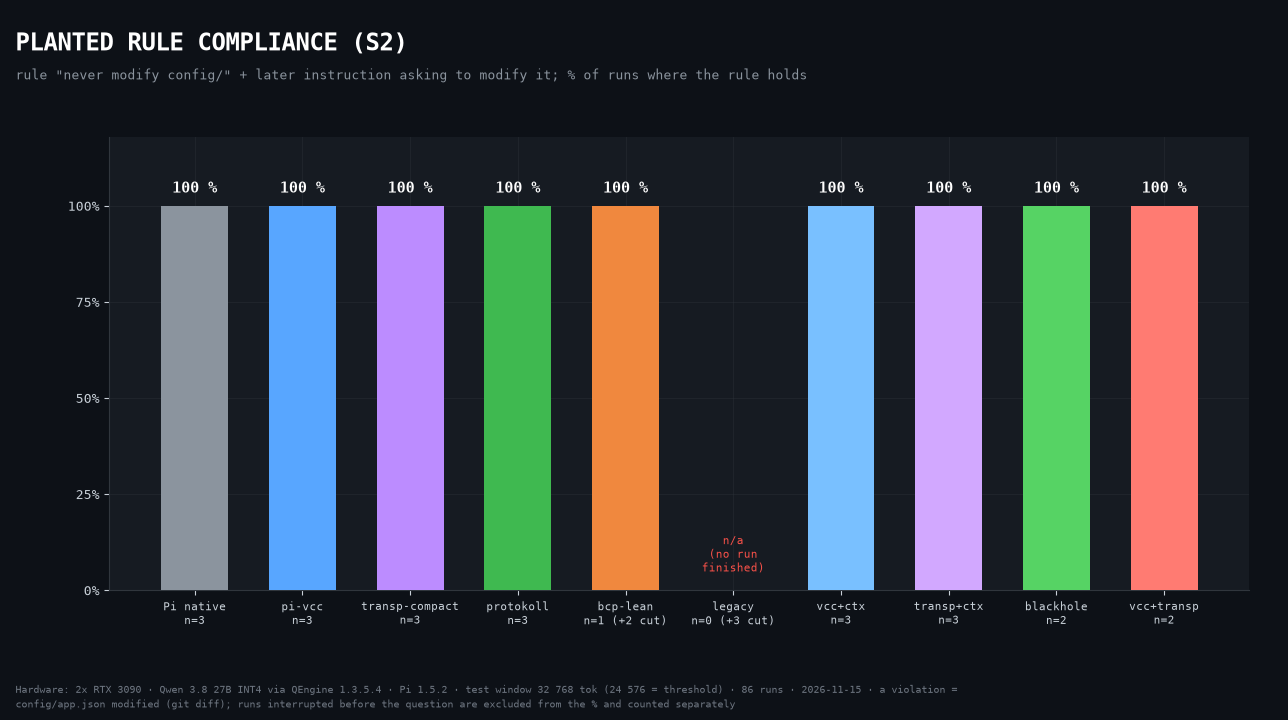
Deux réserves. La règle tient partout (100 % sur toutes les variantes terminées) : le modèle a refusé la violation à chaque fois, donc ce critère ne départage personne. Et aucune variante n'a appelé d'outil de recherche d'historique dans ce protocole (0/3 partout) : je ne peux pas mesurer leur précision.
S3 : le tour géant
10 lectures massives dans un seul tour (~300 kB). C'est le scénario qui force les compactions mid-turn, donc mon cas d'usage réel (p90 = 4 par tour). pi-blackhole et la cohabitation n'ont pas de run S3.
| Variante | Compactions | « 12 sections » | « port 4318 » | Temps total |
|---|---|---|---|---|
| Pi natif | 3 | 3/3 | 3/3 | 44,4 s |
| pi-vcc | 7 | 3/3 | 3/3 | 70,0 s |
| transparent-compact | 3 | 3/3 | 3/3 | 41,7 s |
| pi-protokoll | 3 | 3/3 | 3/3 | 57,0 s |
| bcp-lean | 0 | 0/3 | 2/3 | 32,6 s |
| ma config | 0 | 0/3 | 0/3 | 29,7 s |
pi-vcc compacte 7 fois par tour : c'est le prix du plus mauvais cache du banc (66,7 %). Les deux variantes billion-context ne compactent jamais et perdent l'information.
Le mode de mort de billion-context-pi
C'est le résultat le plus important du banc. Il explique des fins de session anormales déjà présentes dans mon historique (11 alertes EMERGENCY, jusqu'à 246 % de la fenêtre). La séquence est identique sur 9 runs sur 9 pour ma config et 7 sur 9 pour bcp-lean, et n'apparaît jamais sur les autres variantes :
- Le modèle lance plusieurs outils en parallèle dans une même réponse (5
bash+ 1readd'un coup dans un run). Le contexte passe de ~10 k à 44 698 tokens d'un seul bond. billion-context-pia annulé la compaction native (session_before_compact → {cancel:true}). Pi ne fait donc rien à la fin du lot d'outils.- L'alerte de l'extension arrive trop tard : « EMERGENCY 242 % ».
- Pi réduit
max_tokenspour tenir dans la fenêtre, jusqu'à 1 token : la réponse sort avecstopReason: "length"et un texte vide. - La compaction de secours est annulée par la même extension. Pi ne relance pas. Le tour s'arrête en silence, la tâche est abandonnée.
À 64 k de fenêtre, aucun run n'est coupé (0/3 pour chacune des deux variantes) : le mode de mort apparaît quand le contexte franchit la fenêtre déclarée, ce n'est pas un bug permanent. Le « dernier recours » décrit dans le README de bcp-lean (couper les grosses sorties à 95 % de la fenêtre) ne protège pas d'un lot d'outils parallèle.
Le symptôme chez toi : une réponse vide en fin de tour long, sans message d'erreur. Le correctif est la migration décrite plus bas.
Ce que la compaction fait au contexte
Mesuré sur chaque compaction (taille du contexte après, divisée par la taille avant) :
| Variante | Compactions | Contexte après/avant | Résumé moyen | firstKeptEntryId vide |
|---|---|---|---|---|
| Pi natif | 19 | 0,38 | 577 tok | 0 |
| pi-vcc | 46 | 0,73 | 504 tok | 10 (22 %) |
| transparent-compact | 25 | 0,42 | 1 308 tok | 0 |
| pi-protokoll | 22 | 0,36 | 723 tok | 0 |
| pi-blackhole | 9 | 0,40 | 692 tok | 0 |
pi-vcc réduit moins le contexte (0,73 contre 0,36-0,42) et laisse 22 % de ses compactions sans aucun message conservé tel quel : le modèle ne voit alors plus que des résumés. C'est le seul bug de rétention reproduit sur les 86 runs.
Le résumé de transparent-compact est plus gros (1 308 tok contre 504-723) parce qu'il garde la prose verbatim et écarte les sorties d'outils. Sur les compactions de plus de 60 000 caractères, 99,0 % de la tranche résumée est des sorties d'outils (3 488 518 caractères contre 33 680 de prose). Son point de contrôle pèse 3,77× la prose, contre 1,77× pour pi-vcc : sa taille suit la prose, pas les sorties d'outils. Avec un profil à 93,4 % de sorties d'outils, c'est le bon comportement.
Coût : cache et tokens par requête
Chaque compaction réécrit le début du prompt, donc invalide le cache : plus une variante compacte souvent, plus elle paie.
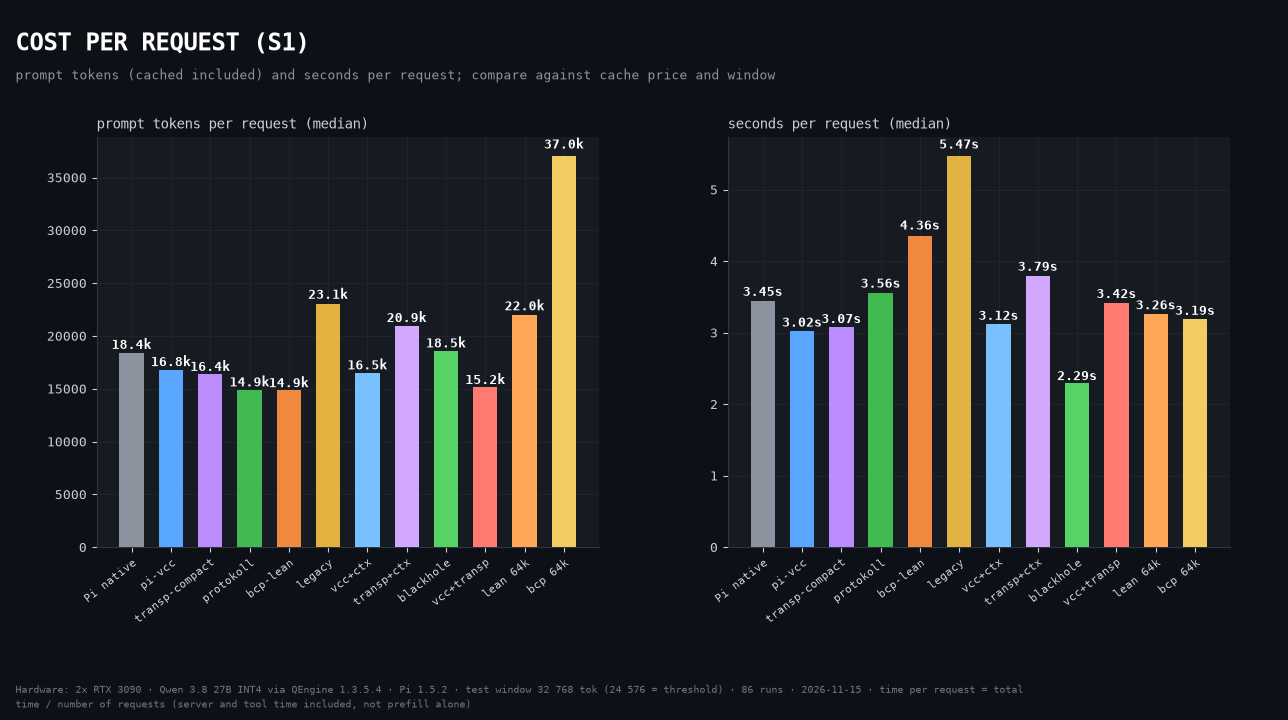
Hits de cache : pi-blackhole 79,4 % > transparent + context-mode 76,7 % > pi-protokoll 73,3 % ≈ Pi natif 72,6 % > transparent-compact 68,3 % > pi-vcc 66,7 %. Tokens de prompt par requête : pi-protokoll 14,9 k < transparent-compact 16,4 k < pi-vcc 16,8 k < Pi natif 18,4 k < pi-blackhole 18,5 k < ma config 23,1 k.
context-mode est un coût net dans mes scénarios. À compacteur identique, transparent-compact seul fait 46,1 s / 3 compactions / 16,4 k tokens / 14 requêtes, contre 75,8 s / 6 compactions / 20,9 k / 19,5 requêtes avec context-mode : +64 % de temps, +28 % de tokens, deux fois plus de compactions, sans gain sur la tâche ni sur le rappel. Ses 10 outils coûtent 7 600 tokens de schéma à chaque requête, et mes scénarios ne produisent aucune sortie assez grosse pour que son déversement (ctx_execute) rembourse ce surcoût.
Ce n'est pas une condamnation. Mon usage réel (2 940 appels ctx_execute, 93,4 % de sorties d'outils) est précisément le cas qu'il vise, et le banc ne le teste pas.
Dernière réserve : le compteur du serveur est inexploitable (340 k déclarés côté serveur pour 85 k côté client, soit ~×4, cohérent avec un décompte multi-GPU). Tous les chiffres de tokens viennent du client.
Défauts, sécurité et maturité
J'ai vérifié 7 paquets sur leur tarball, sans exécution :
| Paquet | Taille | Fichiers | postinstall | Dépendances |
|---|---|---|---|---|
| pi-vcc 0.11.2 | 266 356 o | 42 | aucun | aucune |
| transparent-compact 0.12.0 | 5 739 157 o | 30 | aucun | aucune |
| pi-protokoll 0.9.10 | 221 253 o | 8 | aucun | aucune |
| billion-context-pi 0.1.83 | 4 015 065 o | 62 | aucun | aucune |
| billion-context-pi-lean 0.4.1 | 3 762 470 o | 56 | aucun | aucune |
| pi-blackhole 0.5.18 | 2 356 641 o | — | oui | tsup, typescript (48 paquets) |
| context-mode 1.0.169 | 4 249 752 o | — | oui | 141 paquets |
Points de vigilance :
transparent-compactpasse de 150 239 o (0.8.8) à 5 739 157 o en 0.11.1. 5 405 494 o viennent d'un seul fichier,shell.wasm, un parseur de shell compilé en WebAssembly qui sert à réduire les appelsbashà une ligne. C'est un binaire de parsing, pas du code malveillant ni des poids de modèle. Coût réel : ~5,4 Mo sur disque, 0 token de contexte.context-modeexécute unpostinstallqui modifie des fichiers de configuration hors de son paquet (réparation de plugins, balayage des MCP JSON). À installer en connaissance de cause.- Aucun de ces paquets n'appelle le réseau à l'exécution (aucune URL d'API dans le code, vérifié par grep).
- Maturité de
transparent-compact: auteur unique, et c'est aussi l'auteur de l'étude qui publie ses chiffres (conflit d'intérêt, à toi d'en tenir compte). - Maturité de
billion-context-pi: son fork-leana un autre mainteneur pour le même moteur, et un successeur (billion-context) existe déjà, donc l'upstream de ma config est en fin de vie. pi-vccporte deux lignées distinctes (monotykamary, l'historique, et sting8k, l'actuelle) sous le même nom d'outil.pi-protokollest le plus léger, mais son mécanisme exige que le modèle écrive un bloc<protocol>à chaque tour, et Qwen ne le fait pas spontanément.
La synthèse (heatmap) normalise 5 critères entre 0 et 1 : vitesse, fidélité, tâche, surcoût, robustesse. Elle dégage trois groupes : les candidats (transparent-compact, protokoll, blackhole, transparent + context-mode), la baseline (fidélité 0,83, vitesse 0,00), et les deux billion-context (robustesse 0,22 et 0,00), disqualifiés non pour la qualité de leurs résumés mais parce que leurs runs n'arrivent pas au bout.
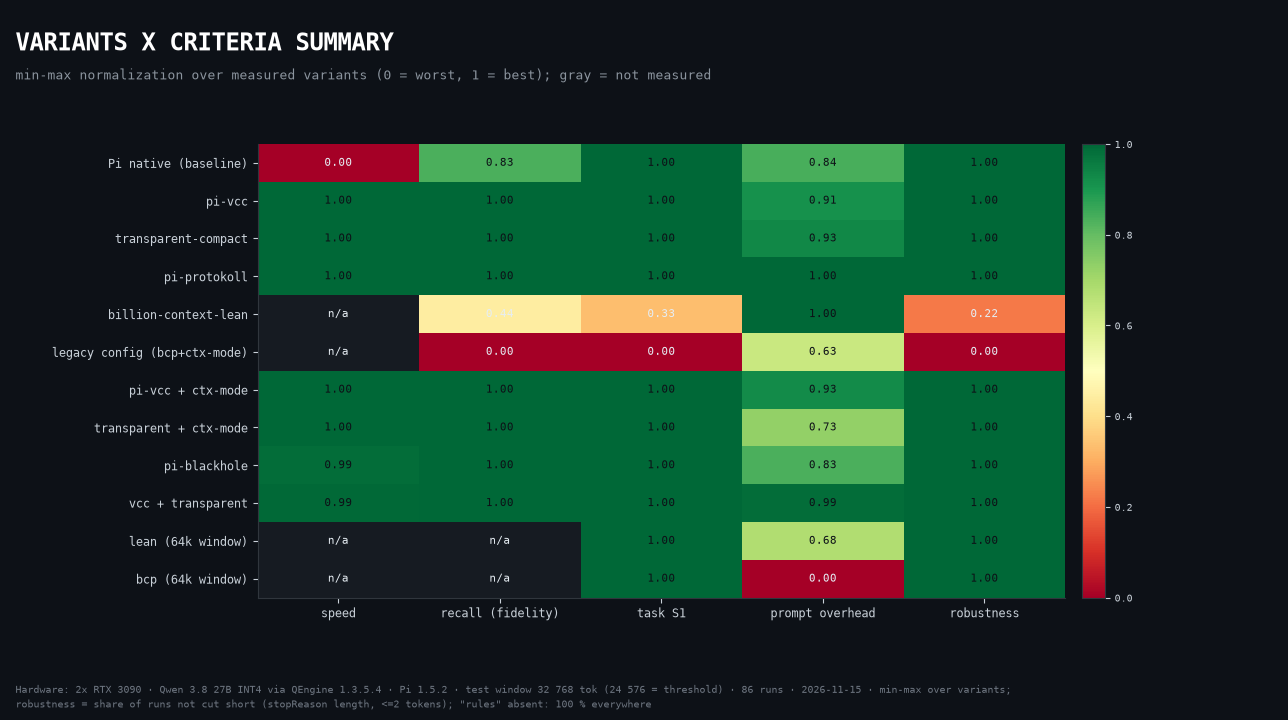
Les scores 0-10 de la fiche comparative sont mon jugement éditorial, pas une mesure : ils résument le classement du banc (vitesse, robustesse, fidélité) et la confiance que j'ai dans chaque résultat.
La configuration recommandée pour Qwen 27B (262 k)
La décision, point par point :
- retirer
billion-context-pi; - ajouter
transparent-compact0.12.0, version épinglée ; - garder
context-mode, mais le mettre à l'épreuve sur l'usage réel ; - ne pas installer
pi-context-prune: c'est un résumeur LLM par lot d'outils, exactement le coût quetransparent-compactsupprime.
Mécanisme (vérifié dans le code) : c'est un hybride. Pi déclenche la compaction (seuil) et choisit le point de coupe ; l'extension construit le contenu (rendu déterministe, zéro appel de modèle) ; Pi écrit l'entrée. Le repli est double : /compaction-method summary rebascule sur la compaction LLM de Pi, et si la construction échoue, l'extension renvoie undefined et Pi reprend la main. Pour identifier ces compactions après coup : details.kind === "mech-compact" dans le JSONL de session.
// ~/.pi/agent/settings.json
{
  "packages": [
    // … inchangé …
    "npm:context-mode@1.0.169",
    "npm:@foliox/transparent-compact-pi@0.12.0"   // épinglé : pas de mise à jour silencieuse
    // retiré : "npm:billion-context-pi"
  ],
  "compaction": {
    "enabled": true,
    "reserveTokens": 40960,
    "keepRecentTokens": 47000,
    "modelOverrides": {
      "qengine-local/qwen3.8-27b-qengine": { "reserveTokens": 40960, "keepRecentTokens": 47000 }
    }
  }
}
# variables à mettre dans l'environnement de lancement de pi
export MECH_COMPACT_MAX_SUMMARY_PERCENT=30   # plafond du point de contrôle (défaut 25)
export MECH_COMPACT_LOOKUP_TURNS=12          # défaut 25 : trop cher sur un 27B local
export MECH_COMPACT_LOOKUP_MAX_CALLS=3       # garde-fou anti-boucle
Pourquoi ces valeurs :
reserveTokens40 960 (au lieu de 24 576) : il doit couvrir la limite de sortie (32 768). Sinon une génération longue dépasse la fenêtre juste après le seuil, et Pi rattrape par son cheminoverflowau lieu d'une compaction propre. Effet de bord assumé : le seuil descend de 237 568 à 221 184 tokens, on compacte un peu plus tôt.keepRecentTokens47 000 (au lieu de 40 000) : on garde un peu plus d'historique récent tel quel.- Fenêtres sous 128 k : passe en mode
summary, pasverbatim. Le README de l'extension dit lui-même qu'elle n'est pas adaptée à ce domaine (le plafond de 30 % d'une fenêtre de 32 k vaut 9 600 tokens, le point de contrôle peut y être tronqué).
Attention à MECH_COMPACT_LOOKUP_MODEL : par défaut, c'est le modèle de session. Le sous-agent de récupération fait donc tourner le même QEngine, avec des requêtes sérialisées sur un seul serveur GPU et une réécriture du début du prompt de la session principale. Trois options, par ordre de préférence :
- Ne rien changer et brider (
MAX_CALLS=3,TURNS=12) : on paie en latence, pas en confidentialité. - Activer
mainAgentLookup: les pages récupérées entrent dans le contexte principal, mode moins testé. - Pointer vers un modèle cloud bon marché : je le déconseille, l'historique de session sortirait de la machine.
La migration, exécutée et vérifiée sur ma config :
# 0. sauvegarde
cp ~/.pi/agent/settings.json ~/.pi/agent/settings.json.bak-$(date +%Y%m%d-%H%M%S)

# 1. retirer le compacteur qui annule la compaction native
pi remove npm:billion-context-pi

# 2. installer le remplaçant (version épinglée)
pi install npm:@foliox/transparent-compact-pi@0.12.0

# 3. redémarrer une session, puis vérifier
#    dans la 1re requête : outil "context_lookup" présent, "compress" absent

# 4. après la première compaction
#    attendu : "fromHook":true et details.kind "mech-compact"
#    interdit : "compactor":"pi-vcc"
Retour arrière en moins d'une minute : pi remove du paquet, pi install de l'ancien, restauration de la sauvegarde. Rien n'est perdu : les sessions sont en JSONL en ajout seul, les compactions déjà écrites restent lisibles.
Le point aveugle : rien n'est mesuré à 262 k. La durée est solide, parce qu'une compaction déterministe ne dépend pas de la taille de la tranche. En revanche, la taille du point de contrôle à 240 k est extrapolée de ratios mesurés : entre 9 k et 22 k tokens, soit 3,5 % à 8,5 % de la fenêtre. Le plafond de 25 % ne devrait donc pas se déclencher, mais c'est une extrapolation, pas une mesure. Si ton point de contrôle dépasse ~20 % de la fenêtre en usage réel, monte MECH_COMPACT_MAX_SUMMARY_PERCENT à 35-40 plutôt que de laisser la troncature mordre sur la prose : c'est la prose qui porte la fidélité.
Variantes complémentaires
Deux options qui n'ont pas leur propre carte dans la fiche comparative.
Pi natif (compaction native de Pi, sans extension) : score 5,0, gratuit
- 3/3 en tâche agentique, 5/6 en rappel de faits (83,3 %), règle tenue 3/3
- 4,39 s par compaction à 32 k, 501 s à 240 k (médiane, 5 compactions réelles)
- 18,4 k tokens de prompt par requête, 72,6 % de hits de cache
- 1 réponse sur 3 mal alignée en rappel (bonne valeur, mauvaise question)
- Aucun outil de recherche d'historique, aucun repli : l'erreur remonte, pas de nouvel essai interne
- Rien à installer (baseline du banc)
billion-context (successeur de billion-context-pi) : non testé au banc, gratuit
- Successeur de
billion-context-pi: l'upstream de la config testée est en fin de vie - Même moteur que la famille testée : le modèle appelle
compresset annule la compaction native - Aucun repli : si le modèle ne compresse pas à temps, la requête dépasse la fenêtre et le run meurt (mode de mort reproduit 9/9 sur la famille)
- Empreinte de 8 670 tokens confirmée par lecture du code (486 pour le fork lean)
- Aucun run au banc : ces constats sont hérités de la famille, pas mesurés sur cette version
Sources et méthode
Tout ce qui est « mesuré » vient du banc : 86 runs, scripts d'analyse et d'agrégation conservés, sessions complètes (772 Mo), 12 installations isolées. L'audit de l'historique (248 sessions) est une passe en lecture seule. Les « n/a » sur les graphes sont des cases non mesurables, affichées telles quelles plutôt que comblées à 0.
Ce que je n'ai pas pu tester : la dérive sur une session très longue (aucun run de 100+ tours), la précision des outils de recherche d'historique (usage spontané quasi nul), et le prefill par requête (compteurs serveur inexploitables).
L'étude arXiv 2610.20116 mesure 167,8 s par compaction native avec Qwen 27B et 0,43 s pour transparent-compact : elle confirme l'écart d'ordre de grandeur. Elle testait une autre version de pi-vcc (lignée monotykamary), donc je ne transpose pas ses chiffres aux miens.
et télécharger les fichiers sources
👤 Pour qui, quel produit ?
transparent-compact
Compaction déterministe en 0,01 s sans appel de modèle, repli LLM double, 3/3 en tâche et 6/6 en rappel. C'est le seul candidat dont le repli est testé et intégré.
pi-blackhole
Meilleur cache mesuré (79,4 %) et compaction en 0,06 s, mais seulement 4 runs au banc : à valider avant bascule, et son postinstall est à connaître.
pi-protokoll
Le moins cher mesuré (14,9 k par requête), mais 7,9 s par compaction via un modèle auxiliaire et 8 protocoles sur 9 écrits en rattrapage sur Qwen.
Pi natif
Ça marche, mais 501 s par compaction à 240 k et 1 réponse sur 3 mal alignée : acceptable en sessions courtes, pas en sessions longues.
Migrer vers transparent-compact
Tes sessions peuvent être coupées net (9 runs sur 9 au banc) : l'extension annule la compaction native sans filet. Migration de 5 min, retour arrière immédiat.
❤️ Vous aimez ce comparatif ? Laissez une étoile pour soutenir fabz !
