

Qwen 3.8 27B sur 2 RTX 3090 + 128GB de RAM : QEngine, ULTRAMAX, vLLM ou llama.cpp ?
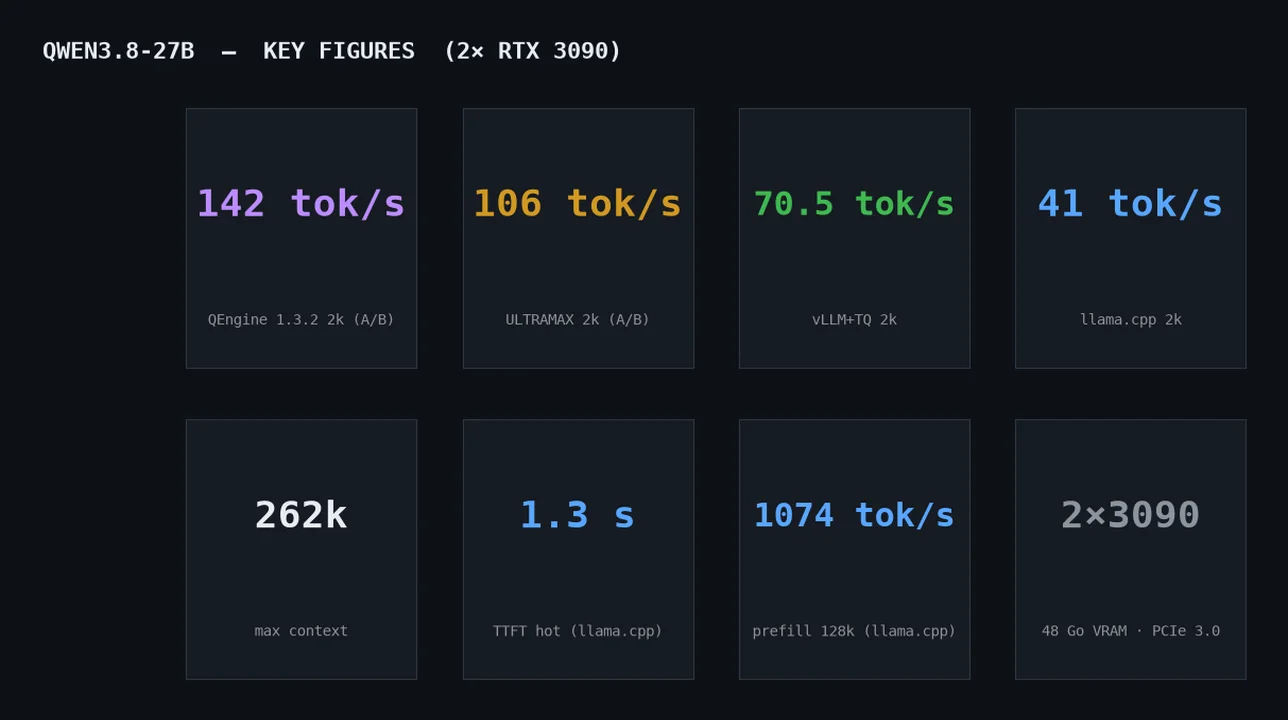
QEngine est le meilleur choix global selon nos tests.
QEngine
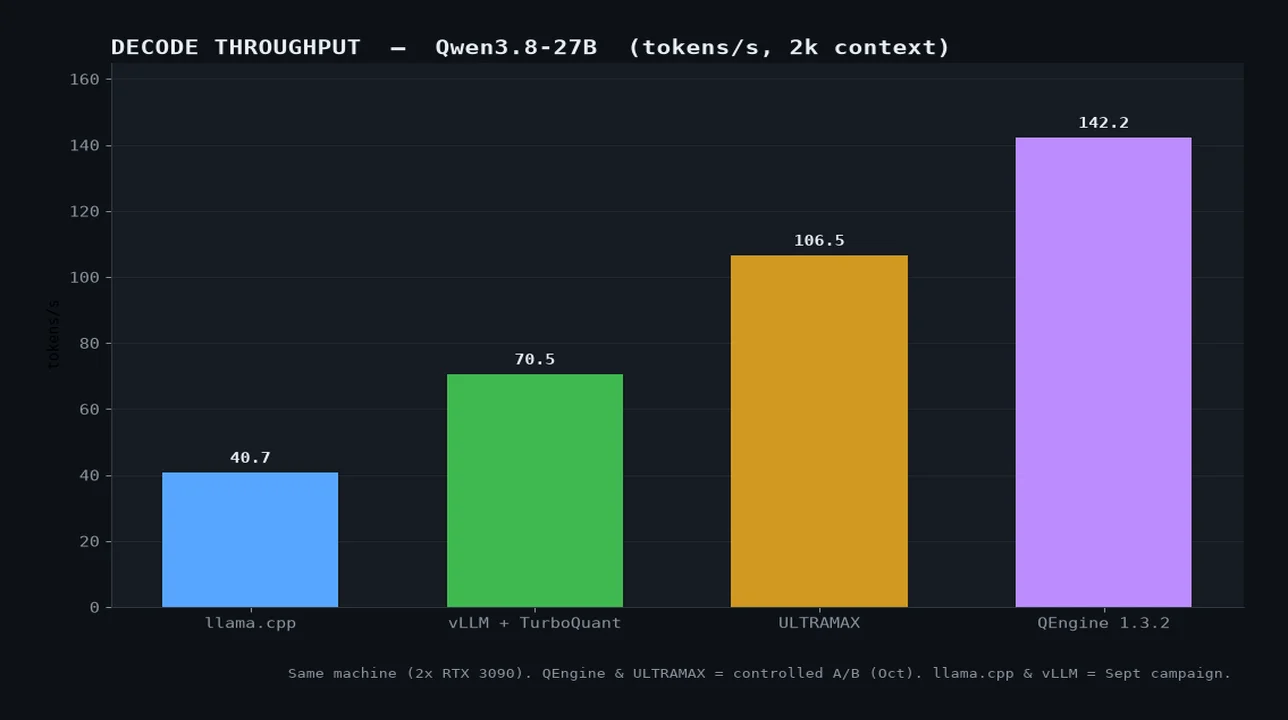
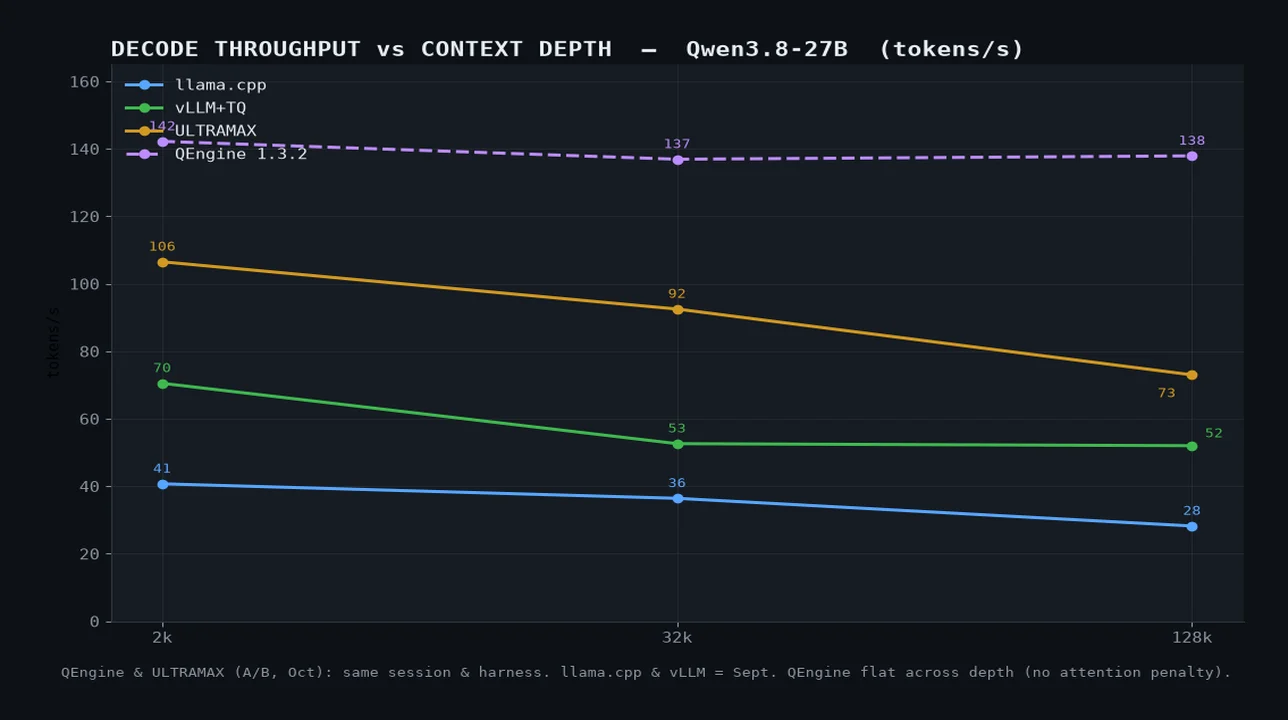
- ✓ Décodage 142 → 138 tok/s de 2K à 128K : quasi aucune perte
- ✓ 32 slots configurés, contexte 262K
- ✓ 0,24 s avant le 1er token sur préfixe en cache à 32K
- ✓ Licence PolyForm Noncommercial, qualité de l'INT4 non mesurée
ULTRAMAX (sous vLLM)
- ✓ 106 / 92 / 73 tok/s à 2K / 32K / 128K en FP8
- ✓ Contexte 262K, drafter DFlash2
- ✓ Pile épinglée non-upstream, mises à jour de vLLM refusées
- ✓ Bug amont connu : workers qui peuvent mourir sous charge agent
TurboQuant (sous vLLM)
- ✓ Upstream, zéro patch, un seul flag (turboquant_k8v4)
- ✓ 70 / 53 / 52 tok/s en médiane, 262K et vision
- ✓ Débit très dispersé d'un run à l'autre (2 runs par point)
- ✓ Le format du KV décide tout : 8,6 tok/s à 128K en bf16
llama.cpp
- ✓ 1,2 à 1,4 s avant le 1er token sur préfixe en cache à 128K
- ✓ Moteur simple, aucun trafic entre cartes par token
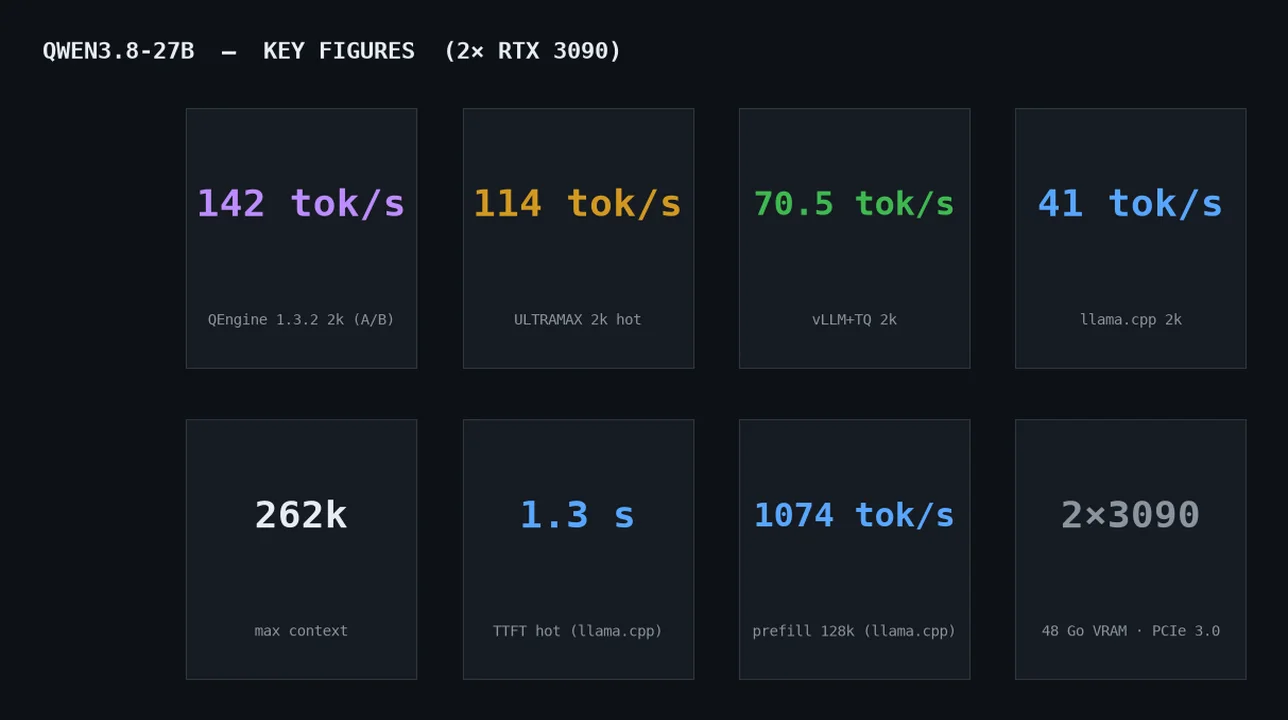
- ✓ 40,7 / 36,4 / 28,2 tok/s en Q8_K_XL, le plus lent en décodage
- ✓ Piège du --tensor-split équilibré : OOM silencieux
Aussi disponible enanglaisfrançais(original)
Le résultat tient en une phrase : QEngine décode 1,3 à 1,9 fois plus vite qu'ULTRAMAX et ne ralentit presque pas quand le contexte grandit, mais sur un contexte déjà en cache, QEngine (0,24 s à 32K) et llama.cpp (1,3 s à 128K) répondent presque instantanément, là où ULTRAMAX met 4 à 7 s. Le bon choix dépend donc de ce que tu fais du modèle, pas seulement de sa vitesse affichée.
En 30 secondes
| Tu veux… | Prends… | Pourquoi | À savoir |
|---|---|---|---|
| Décoder vite, même sur un très long contexte, ou servir plusieurs agents | QEngine | 138 tok/s à 128K, 32 slots, 0,24 s sur préfixe en cache à 32K | licence non commerciale, qualité de l'INT4 non mesurée par moi, TTFT à chaud non mesuré à 128K |
| Un agent qui rejoue un long contexte, avec un moteur simple | llama.cpp | 1,3 s avant le premier token sur préfixe en cache à 128K | 3,5 à 5 fois plus lent en décodage |
| Rester upstream, sans patch | vLLM 0.30 + TurboQuant | 70 / 53 / 52 tok/s en médiane, 262K, un seul flag | débit très dispersé d'un run à l'autre, sorties à revérifier, TTFT à chaud non mesuré |
| Le maximum de débit en FP8 | ULTRAMAX | 106 / 92 / 73 tok/s à 2K / 32K / 128K | pile épinglée non-upstream, bug amont connu |
Chez moi, QEngine est le moteur par défaut pour le 27B (version 1.3.5.4).
Pourquoi ce modèle change la comparaison
Qwen 3.8 27B est un modèle dense : ses 27 milliards de paramètres sont lus à chaque token. Contrairement à QFN, il n'y a pas d'experts à décharger en RAM, donc la RAM compte peu ici. Tout se joue dans la VRAM, sur 2 leviers : la quantification des poids (ce qu'il faut lire à chaque token) et celle du cache KV (qui grossit avec le contexte).
Les poids que j'ai servis : 31,5 Go en Q8_K_XL (llama.cpp), environ 27 Go en FP8 (vLLM, ULTRAMAX), 19,5 Go en INT4 (QEngine).
Quelques mots à connaître pour la suite :
- tok/s : tokens générés par seconde (le décodage).
- Préfill : la vitesse à laquelle le moteur lit ton prompt. TTFT : le temps avant le premier token. À froid, le contexte n'a jamais été vu. À chaud, il est déjà en cache : les deux n'ont rien à voir.
- Cache KV : la mémoire de l'attention. Son format (bf16, fp8, int8, TurboQuant) pèse très lourd en contexte long.
- Drafter / MTP / DFlash2 : un petit modèle propose plusieurs tokens d'avance, le gros les valide. Ça accélère sans changer la qualité de sortie. L'acceptance est le nombre moyen de tokens obtenus par vérification.
- P2P : transfert direct d'une carte à l'autre, sans passer par la RAM. Mes cartes n'en ont pas.
Ma machine
2 RTX 3090 de 24 Go (une Ti de 300 W et une 3090 de 275 W), un AMD EPYC 7401P de 24 cœurs, 128 Go de DDR4, PCIe 3.0 x16 sur les deux cartes, pas de NVLink et pas de P2P (ma carte mère GIGABYTE MZ31-AR0 ne l'autorise pas). Deux écrans sont branchés sur les cartes, ce qui grignote de la VRAM. Avec 48 Go, je ne fais tourner qu'un moteur à la fois.
Sans P2P, vLLM en tensor parallel fait passer chaque échange entre cartes par la RAM de la machine, environ 128 collectifs par token. llama.cpp, en répartition par couches, n'a aucun trafic entre cartes par token. C'est une des raisons pour lesquelles il reste compétitif malgré un moteur plus rustique.
Les 4 moteurs en un tableau
| QEngine | ULTRAMAX | vLLM 0.30 stock | llama.cpp | |
|---|---|---|---|---|
| Version testée | 1.3.2 (A/B), 1.3.5.4 (au quotidien) | vLLM 0.29 + noyau FA2 fp8-KV patché | 0.30 | build master (11141) |
| Poids | INT4 W4A16, 19,5 Go | FP8 W8A16, ~27 Go | FP8 W8A16, ~27 Go | Q8_K_XL ≈ 8,5 bit, 31,5 Go |
| Cache KV | FP8 | FP8 | TurboQuant k8v4 | q8_0 |
| Drafter | MTP fusionnée | DFlash2 W4A16 (n=7) | MTP | MTP intégré (n=2) |
| Contexte max | 262K | 262K | 262K | 262K |
| Slots configurés | 32 | 1 | — | 1 |
| Démarrage à froid | 54 s (1.3.2), 45 s (1.3.5.4) | 153 s (5 à 8 min au tout premier) | — | — |
| Licence | PolyForm Noncommercial | Apache-2.0 (vLLM) + artefact binaire tiers | Apache-2.0 | MIT |
QEngine contre ULTRAMAX : même session, mêmes scripts
C'est la seule comparaison strictement contrôlée : même soirée, mêmes prompts (corpus de code de 2 132 / 32 132 / 128 132 tokens), 5 runs par prompt, médiane. Chaque prompt est précédé d'un préfixe unique pour garantir un préfill froid, et le décodage est mesuré après, donc à la vraie longueur de contexte.
| Contexte | QEngine 1.3.2 | ULTRAMAX | Écart | |
|---|---|---|---|---|
| Décodage (tok/s) | 2K | 142,2 | 106,5 | +33,5 % |
| 32K | 136,9 | 92,5 | +48,0 % | |
| 128K | 137,9 | 73,0 | +88,8 % | |
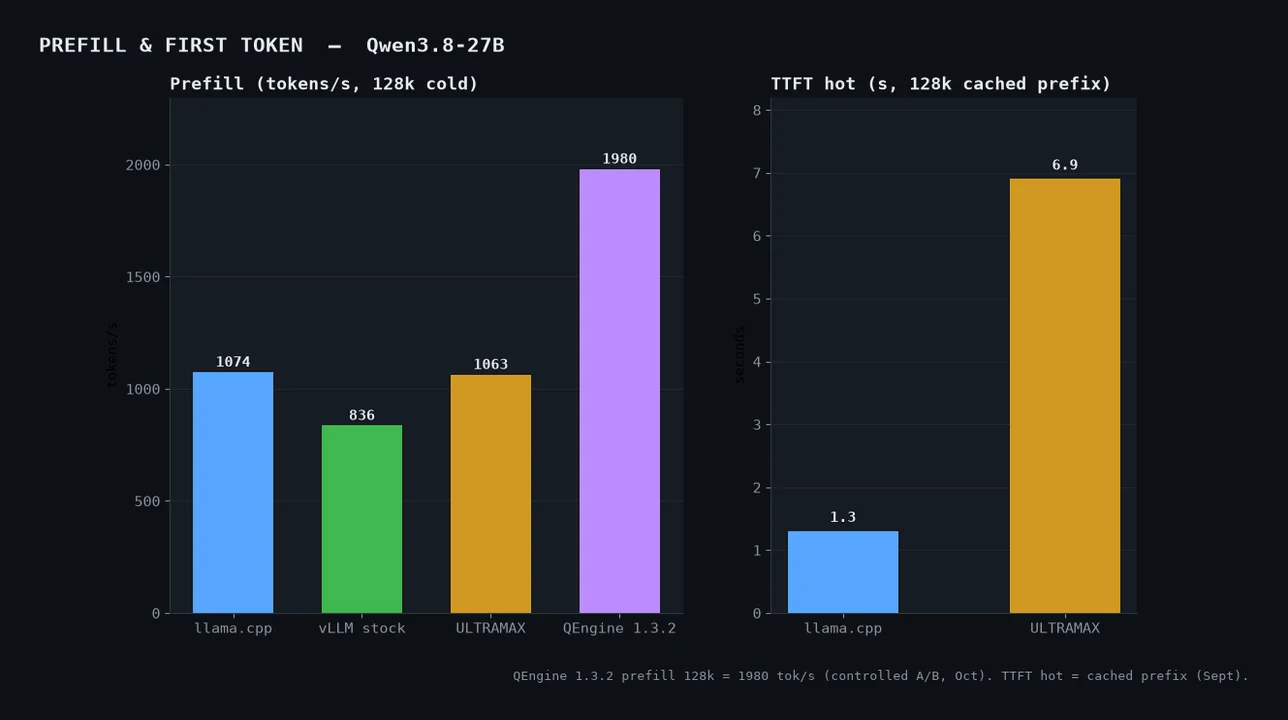
| Préfill (tok/s) | 2K | 2 131 | 1 463 | +45,6 % |
| 32K | 2 226 | 1 399 | +59,1 % | |
| 128K | 1 980 | 1 146 | +72,8 % | |
| Attente avant la 1re réponse à 128K | 64,7 s | 111,9 s | −47,1 s | |
| Démarrage à froid | 54 s | 153 s |
Écarts exprimés du point de vue de QEngine. Les médianes viennent de 5 runs, sauf QEngine à 2K (4 runs, voir « Sources et méthode »).
Le décodage. C'est là que QEngine se distingue : il perd 3 % entre 2K et 128K (142,2 → 137,9), alors qu'ULTRAMAX en perd 31 % (106,5 → 73,0). L'écart se creuse donc avec le contexte. Mes hypothèses : poids INT4 (7,2 Go par carte contre 13,5 Go, donc environ 2 fois moins à lire par token), MTP fusionnée dans le moteur, et pool KV plus généreux. Je n'ai isolé aucune de ces causes.
Le contexte et les slots. Le pool KV de QEngine fait 343 040 tokens contre 267 493 pour ULTRAMAX, et il est partagé par 32 slots. Attention : ULTRAMAX est configuré à 1 slot. Je n'ai pas lancé de test de charge concurrente, donc « 32 slots » est une capacité configurée, pas un débit mesuré.
La licence. QEngine est sous PolyForm Noncommercial 1.0.0 : à regarder de près si ton usage dépasse le cadre personnel.
Les 2 autres, en bref
llama.cpp. Chiffres de septembre, avec le réglage final (Q8_K_XL, MTP n=2) : 40,7 / 36,4 / 28,2 tok/s à 2K / 32K / 128K. C'est le plus lent du lot, mais c'est le seul à gagner sur un préfixe déjà en cache : 1,2 à 1,4 s avant le premier token à 128K, contre 6,9 s pour ULTRAMAX, parce qu'il ne réévalue que 4 tokens. À froid, c'est l'égalité : 119 s pour llama.cpp (1 074 tok/s), 120 s pour ULTRAMAX (1 063 tok/s) lors de la campagne de septembre. Pour un agent qui poursuit la même conversation, c'est un critère qui compte beaucoup. QEngine semble faire aussi bien, mais je ne l'ai mesuré que jusqu'à 32K (voir plus bas).
vLLM 0.30 + TurboQuant. --kv-cache-dtype turboquant_k8v4 donne 70,5 / 52,6 / 52,0 tok/s en médiane à 2K / 32K / 128K, avec 262K, la vision et 344 926 tokens de capacité KV. Zéro patch, un seul flag. Le cache KV pèse énormément : le même vLLM avec un KV bf16 tombe à 8,6 tok/s à 128K (et plafonne à 131K), et à 5,9 avec un KV int8. Attention à ces médianes : elles viennent de 2 runs par point, très dispersés (36,9 et 68,3 tok/s à 32K ; 37,4 et 66,6 à 128K). Les sorties de ces runs montrent aussi des boucles de répétition dès les premiers tokens, ce qui peut gonfler le débit d'un drafter ; je ne les ai pas revérifiées. Je n'ai pas mesuré son TTFT à chaud.
TTFT à chaud : ce que j'ai, et ce qui manque
Le TTFT à chaud, c'est le temps avant le premier token quand le préfixe est déjà en cache : le cas d'un agent qui poursuit une conversation.
| Moteur | 2K | 32K | 128K |
|---|---|---|---|
| QEngine 1.3.2 | 0,12 s | 0,24 s | non mesuré |
| ULTRAMAX | 2,0 s* | 4,4 s | 6,9 s |
| llama.cpp | non mesuré | non mesuré | 1,2 à 1,4 s |
| vLLM + TurboQuant | non mesuré | non mesuré | non mesuré |
*À 2K, le débit affiché (1 050 tok/s) est celui d'un préfill froid : ce n'est pas un vrai TTFT à chaud.
Les chiffres de QEngine viennent de ma première passe de l'A/B, avec le même prompt à chaque run : je l'avais écartée pour le préfill, mais elle est valable pour le cache. À 2K, 4 runs sur 5 sont en cache (le premier est froid, à 1,0 s) ; à 32K, les 5 le sont. Les autres colonnes viennent de septembre, donc d'une autre session.
À 32K, QEngine est environ 18 fois plus rapide qu'ULTRAMAX sur préfixe en cache (0,24 s contre 4,4 s). La pente de QEngine (0,12 → 0,24 s entre 2K et 32K) est encourageante, mais deux points ne font pas une mesure à 128K : je ne peux donc pas dire s'il bat llama.cpp (1,2 à 1,4 s) sur le très long contexte.
La comparaison n'est pas à quantification égale
QEngine tourne en INT4 : c'est une partie de sa vitesse. Le bon point de comparaison côté llama.cpp est donc le Q4_K_XL (4,5 bit), mesuré en septembre : 60,7 / 52,3 / 34,7 tok/s, soit +49 % à 2K par rapport au Q8. QEngine reste très au-dessus (142 / 137 / 138), mais ce n'est pas la même session, donc prends l'écart comme un ordre de grandeur.
Ce que coûte chaque réglage, avec des chiffres mesurés quand j'en ai et publiés sinon :
- Décodage spéculatif (MTP, DFlash2) : aucun effet sur la qualité de sortie, le drafter propose et le modèle cible valide. Il change la vitesse, jamais le résultat.
- KV en 8 bits (q8_0, fp8, int8) : quasi identique au bf16 (perplexité 7,14 contre 7,15). La sortie n'est pas reproductible bit à bit, mais la qualité tient.
- TurboQuant k8v4 : 2 fois moins de mémoire pour +1,17 % de perplexité d'après le blog vLLM, et 0,973 contre 1,000 sur MRCR-16 d'après une reproduction indépendante.
- KV en 4 bits symétrique : catastrophe, perplexité de 1 573 contre 7,15. À éviter absolument.
- Poids en 4 bits : dégradation réelle mais douce, très dépendante de la tâche. Sur ma sonde de 5 tâches, le Q4_K_XL fait 4/5 contre 5/5 pour le Q8. Cette sonde est trop courte pour trancher.
Le trou de mon comparatif : je n'ai pas mesuré la qualité de l'INT4 de QEngine. Il passe mes tests fonctionnels sans problème (voir plus bas), mais je n'ai pas de banc qui compare sa fidélité au FP8 ou au Q8. Si ta tâche est sensible à la précision (raisonnement long, extraction), teste-le sur tes propres cas avant de t'y fier.
QEngine 1.3.5.4 : le moteur que j'utilise vraiment
Le A/B ci-dessus est en 1.3.2. Au quotidien, je suis passé en 1.3.5.4, mesuré dans une session distincte, avec un autre harnais (bench.sh) : ce n'est pas un A/B, prends ces chiffres comme un ordre de grandeur.
| Mesure (1.3.5.4) | Valeur |
|---|---|
| Décodage narratif / code, contexte court | 191,1 / 265,2 tok/s |
| Préfill à 10K / 90K | 2 311 / 2 124 tok/s |
| Acceptance du drafter (MTP) | 6,05 |
| VRAM de la carte la plus chargée | 21 690 MiB |
| Tests fonctionnels / vision | 10/10 · 4/4 |
| Tests de stress long contexte | 8/8, jusqu'à 240 659 tokens (91 % de 262K) |
| VRAM libre par carte à 240K | 1 117 MiB |
Le gain face au 1.3.2 (142 tok/s) ne se compare pas proprement : version, session et harnais ont changé en même temps, et ce n'est pas le même type de prompt (ici narratif et code, là un corpus de code). L'acceptance dépend aussi du contenu généré.
Les pièges rencontrés
Le prefix cache fausse tout préfill. Ma première passe avec un prompt identique à chaque run affichait « 18 000 tok/s » de préfill : c'était un hit de cache, pas un préfill. Il faut un préfixe unique devant chaque prompt, et le script vérifie qu'aucun hit suspect ne passe (0 sur les 30 runs retenus).
Le format du cache KV décide du long contexte. À 128K, avec le même moteur : bf16 8,6 tok/s, int8 5,9, TurboQuant 52. « Ça tient en 262K » ne veut pas dire « c'est utilisable ».
Un p-min qui coûte cher. Mon ancienne unité llama.cpp avait un MTP à n=6 et --spec-draft-p-min 0.75. Passer à n=2 sans p-min donne +10 % à 2K en médiane (38,5 → 42,4), et le p-min seul coûte 17 % à 2K et 13 % à 32K. Attention : 3 runs par réglage et une dispersion de ±10 % d'un run à l'autre, donc je le tiens pour probable plus que démontré. L'unité n'avait de plus aucun sampler explicite, donc le serveur tournait avec les défauts llama.cpp, hors de ce que préconise la model card.
Le split des GPU sur llama.cpp. Un --tensor-split équilibré provoque un OOM silencieux : le serveur démarre quand même, en repli (retrying without pipeline parallelism). Il faut déséquilibrer (55/45) pour laisser de la place au drafter, et vérifier les logs à chaque changement.
ULTRAMAX est fragile. Une pile d'outils CUDA mixte (nvcc, headers et nvidia-nvvm à des versions différentes) donne des erreurs successives jusqu'à un ptxas: Unsupported .version. Le contrôle ABI de l'artefact refuse aussi toute mise à jour de vLLM, et il y a un bug amont (club-3090#50021) : avec un drafter, des workers peuvent mourir sous trafic agent soutenu. Je l'ai installé sans Docker, faute de NVIDIA Container Toolkit.
vLLM n'alloue pas si la VRAM est occupée. Un ancien processus orphelin suffit à faire échouer le démarrage avec Engine core initialization failed. Arrête tout proprement avant de changer de moteur.
Mes réglages QEngine
À recopier tels quels si tu pars du preset du 27B :
QE_MAX_SEQS=32
QE_KV_ARCHIVE_GB=24
QE_RESERVE_GB=2,2
QE_PRESENCE_PENALTY=0.3
QE_FREQUENCY_PENALTY=0
Le frequency_penalty à 0,3 provoquait une dérive lexicale, donc je le laisse à 0. En 1.3.5.4, les budgets de raisonnement sont natifs : 8 192 tokens en low, 16 384 en medium, 32 768 en xhigh. Je garde aussi le dashboard et les métriques en loopback seul.
Si tu restes sur llama.cpp, la base qui m'a donné le meilleur résultat : -c 262144 -fa on -np 1 -ngl 999 -b 4096 -ub 512 --split-mode layer --tensor-split 55,45 -ctk q8_0 -ctv q8_0 --spec-type draft-mtp --spec-draft-n-max 2, plus le sampler de la model card (--temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.0).
Sources et méthode
Tout ce qui est chiffré vient de mon banc, sauf les chiffres de qualité publiés (perplexité des formats KV, TurboQuant), cités avec leur source.
- Campagne de septembre (llama.cpp, vLLM, ULTRAMAX) : 1 chauffe puis 2 runs, médiane, préfill froid.
- A/B du 31 octobre (QEngine 1.3.2 contre ULTRAMAX) : harnais
cold_prefill.py, 5 runs par prompt, 256 tokens générés avecignore_eos. Un run de QEngine à 2K est exclu (TTFT de 20 s après une requête 128K interrompue par unkill), d'où n=4. - QEngine 1.3.5.4 :
bench.shde club-3090, 3 chauffes puis N mesures, une seule session. - Sampling identique partout :
temperature 1.0, top_p 0.95, top_k 20. Lereasoning_effortn'était pas identique (low pour ULTRAMAX, xhigh par défaut pour QEngine), sans effet sur les tok/s puisque la sortie est forcée à 256 tokens.
Comparer entre campagnes demande de la prudence. Mon A/B reproduit septembre à +9 % pour le décodage ULTRAMAX à 2K, mais à +19 % à 32K (92,5 contre 78,0) et +16 % à 128K (73,0 contre 63,2). Explication probable : noyau 6.8.0-117 et écrans plus légers, que je n'ai pas isolée. Les chiffres de septembre pour llama.cpp et vLLM sont donc probablement un peu bas par rapport à ceux d'aujourd'hui. Seul l'écart QEngine / ULTRAMAX est strictement comparable.
Ce que je n'ai pas mesuré : la qualité de l'INT4 de QEngine (ni GSM8K ni IFEval), le TTFT à chaud de QEngine à 128K et de vLLM + TurboQuant à toutes les longueurs, la charge concurrente (c=8/16/32), la stabilité au-delà d'une heure, et le bras « avec gpu-unlock » de l'A/B.
Sources publiées : club-3090 (configs de référence 2×3090), blog vLLM sur TurboQuant, reproduction MRCR de TurboQuant, kvbits (asymétrie clé/valeur du KV), gguf-bench (qualité des quantifications GGUF). Un débit sans quantification ni longueur de contexte ne vaut rien : compare toujours à poids et contexte égaux.
et télécharger les fichiers sources
👤 Pour qui, quel produit ?
QEngine
138 tok/s à 128K, soit 1,9 fois ULTRAMAX, avec une perte de 3 % seulement entre 2K et 128K. Teste l'INT4 sur tes cas si la précision compte.
llama.cpp (ou QEngine)
1,2 à 1,4 s avant le premier token à 128K sur préfixe en cache, avec un moteur simple. QEngine semble aussi bon (0,24 s à 32K) mais n'est pas mesuré à 128K.
QEngine
32 slots configurés et un pool KV de 343 040 tokens. C'est une capacité configurée : je n'ai pas lancé de test de charge concurrente.
TurboQuant
Un seul flag, 262K et vision, environ 52 tok/s à 128K. Débit dispersé et sorties à revérifier : à valider chez toi.
ULTRAMAX
106 / 92 / 73 tok/s à 2K / 32K / 128K, mais pile épinglée non-upstream et bug amont connu sous trafic agent soutenu.
llama.cpp ou vLLM
Licences MIT et Apache-2.0. QEngine est sous PolyForm Noncommercial : à lire de près au-delà du cadre personnel.
❤️ Vous aimez ce comparatif ? Laissez une étoile pour soutenir fabz !
